Ogni tanto un annuncio merita più di un titolo letto di corsa. Il 15 settembre Diogo Almeida, uno degli autori del paper InstructGPT, la ricerca sul reinforcement learning from human feedback da cui è nato il comportamento di ChatGPT, ha presentato TypeSafe AI e il suo primo modello pubblico: Jev. La domanda da cui parte è sua: perché modelli superumani nella conversazione non hanno portato a un salto nell'automazione? La risposta che si è dato: perché il collo di bottiglia non è l'intelligenza, ma il fatto che l'intelligenza parla quando dovrebbe limitarsi a decidere.
TypeSafe è una startup di San Francisco con 40 milioni di dollari di seed guidati da DCVC. Jev è il primo esemplare di quella che l'azienda chiama una nuova classe di modelli, i System One Models, addestrati con un metodo nuovo, RLCD, e pensati per il software più che per le persone.
Cosa fa Jev, in pratica
Jev non scrive. Non è un LLM ridotto e non è un chatbot: è un modello di decisione. Prende in ingresso testo o stato strutturato (JSON) e risponde a domande tipizzate, con tre primitive: Choice (scegli un'opzione da una lista, fino a 255), Score (una posizione su una scala) e Noul (un sì o no con probabilità). L'output non è prosa da interpretare, ma un valore tipizzato con la distribuzione di probabilità e una stima di confidenza calibrata: se dice 0,8, deve avere ragione circa otto volte su dieci.
La differenza tecnica sta nel campionamento. Un LLM genera un token alla volta, in sequenza; Jev calcola tutte le risposte possibili in una sola passata parallela, perché lo spazio delle uscite è definito in anticipo. Da lì vengono velocità e costi, e anche una proprietà interessante: le risposte non possono uscire dallo schema, quindi gli errori di formato sono impossibili per costruzione.
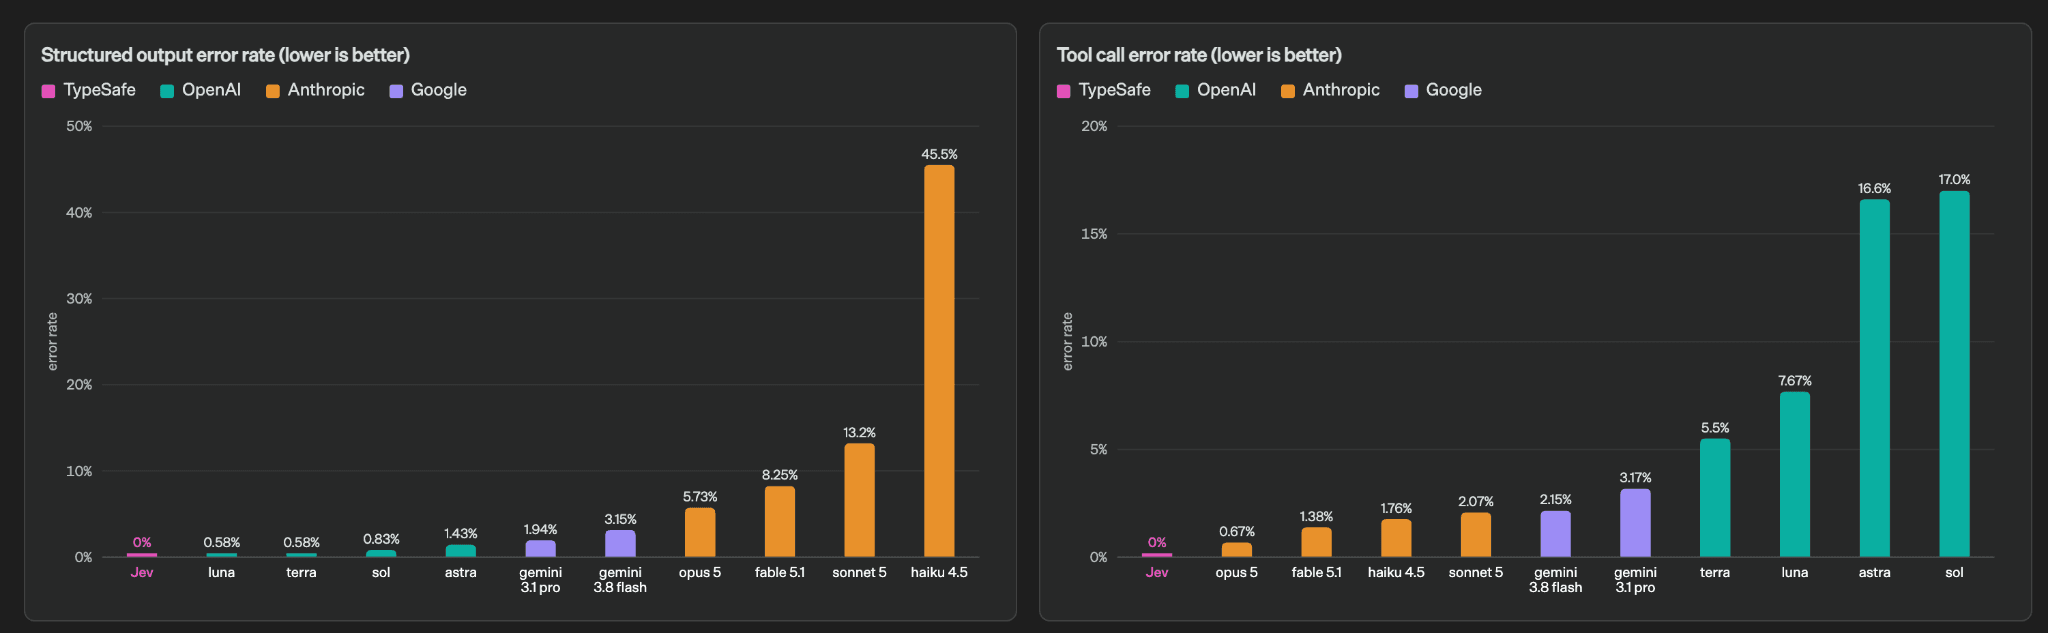
I numeri dichiarati
- Velocità end-to-end: 70-500 ms contro 3-329 secondi dei modelli frontier
- Prezzo: 0,042 $ per milione di token in input (42 $ per miliardo), output gratuiti
- Differenza dichiarata: 20-200 volte più veloce e 40-400 volte più economico su domande di tipo System One
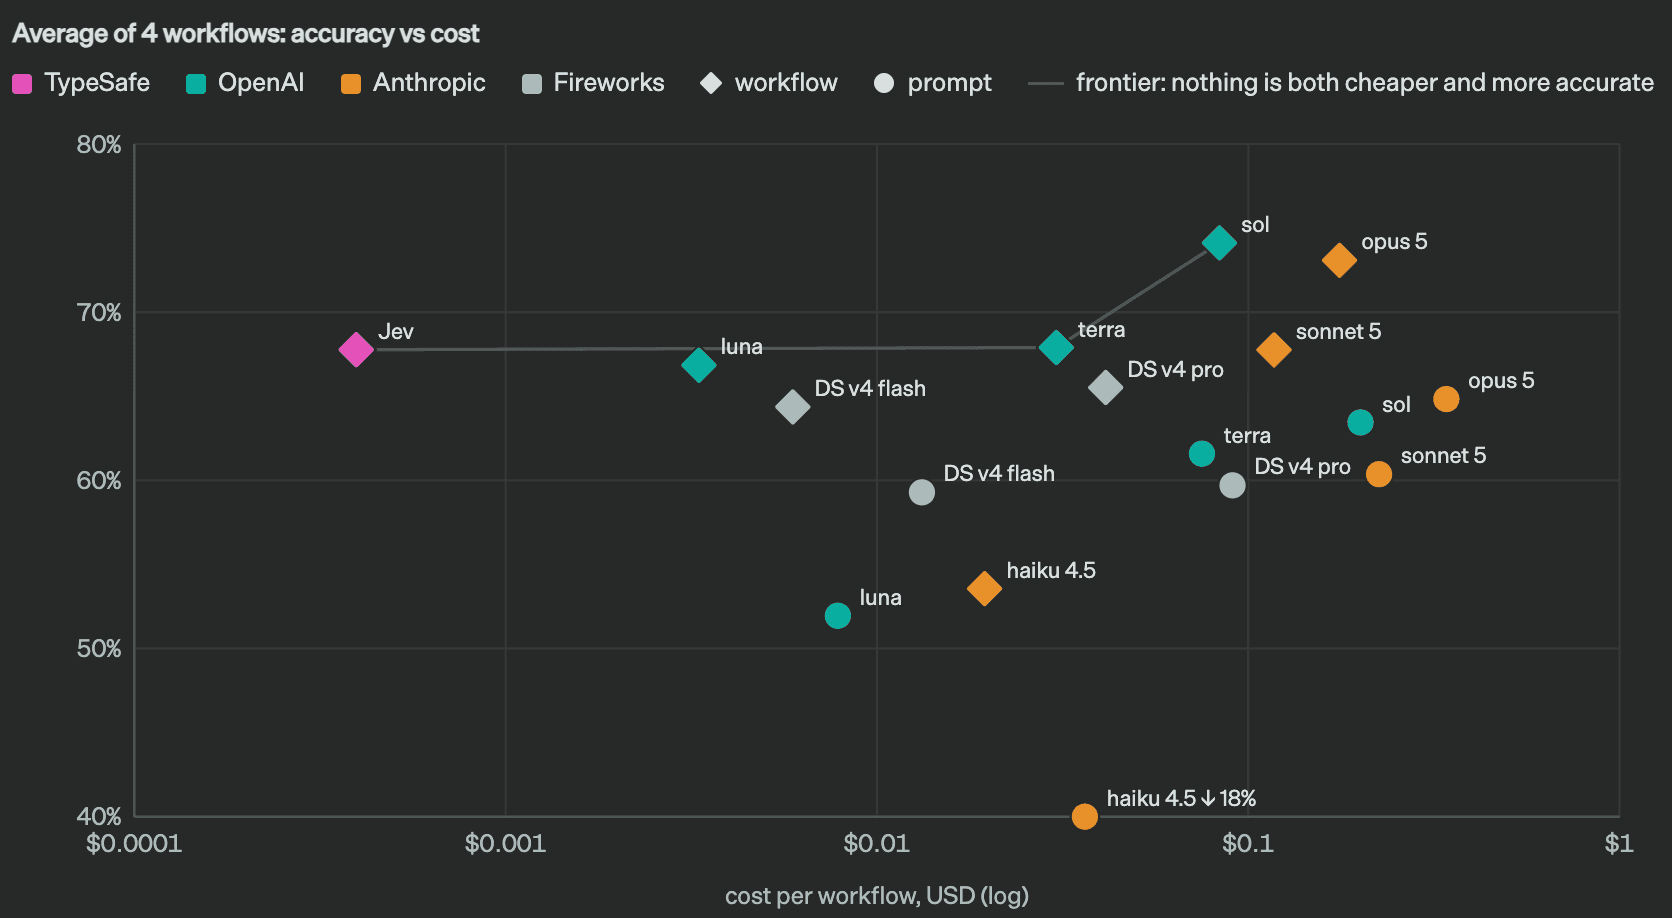
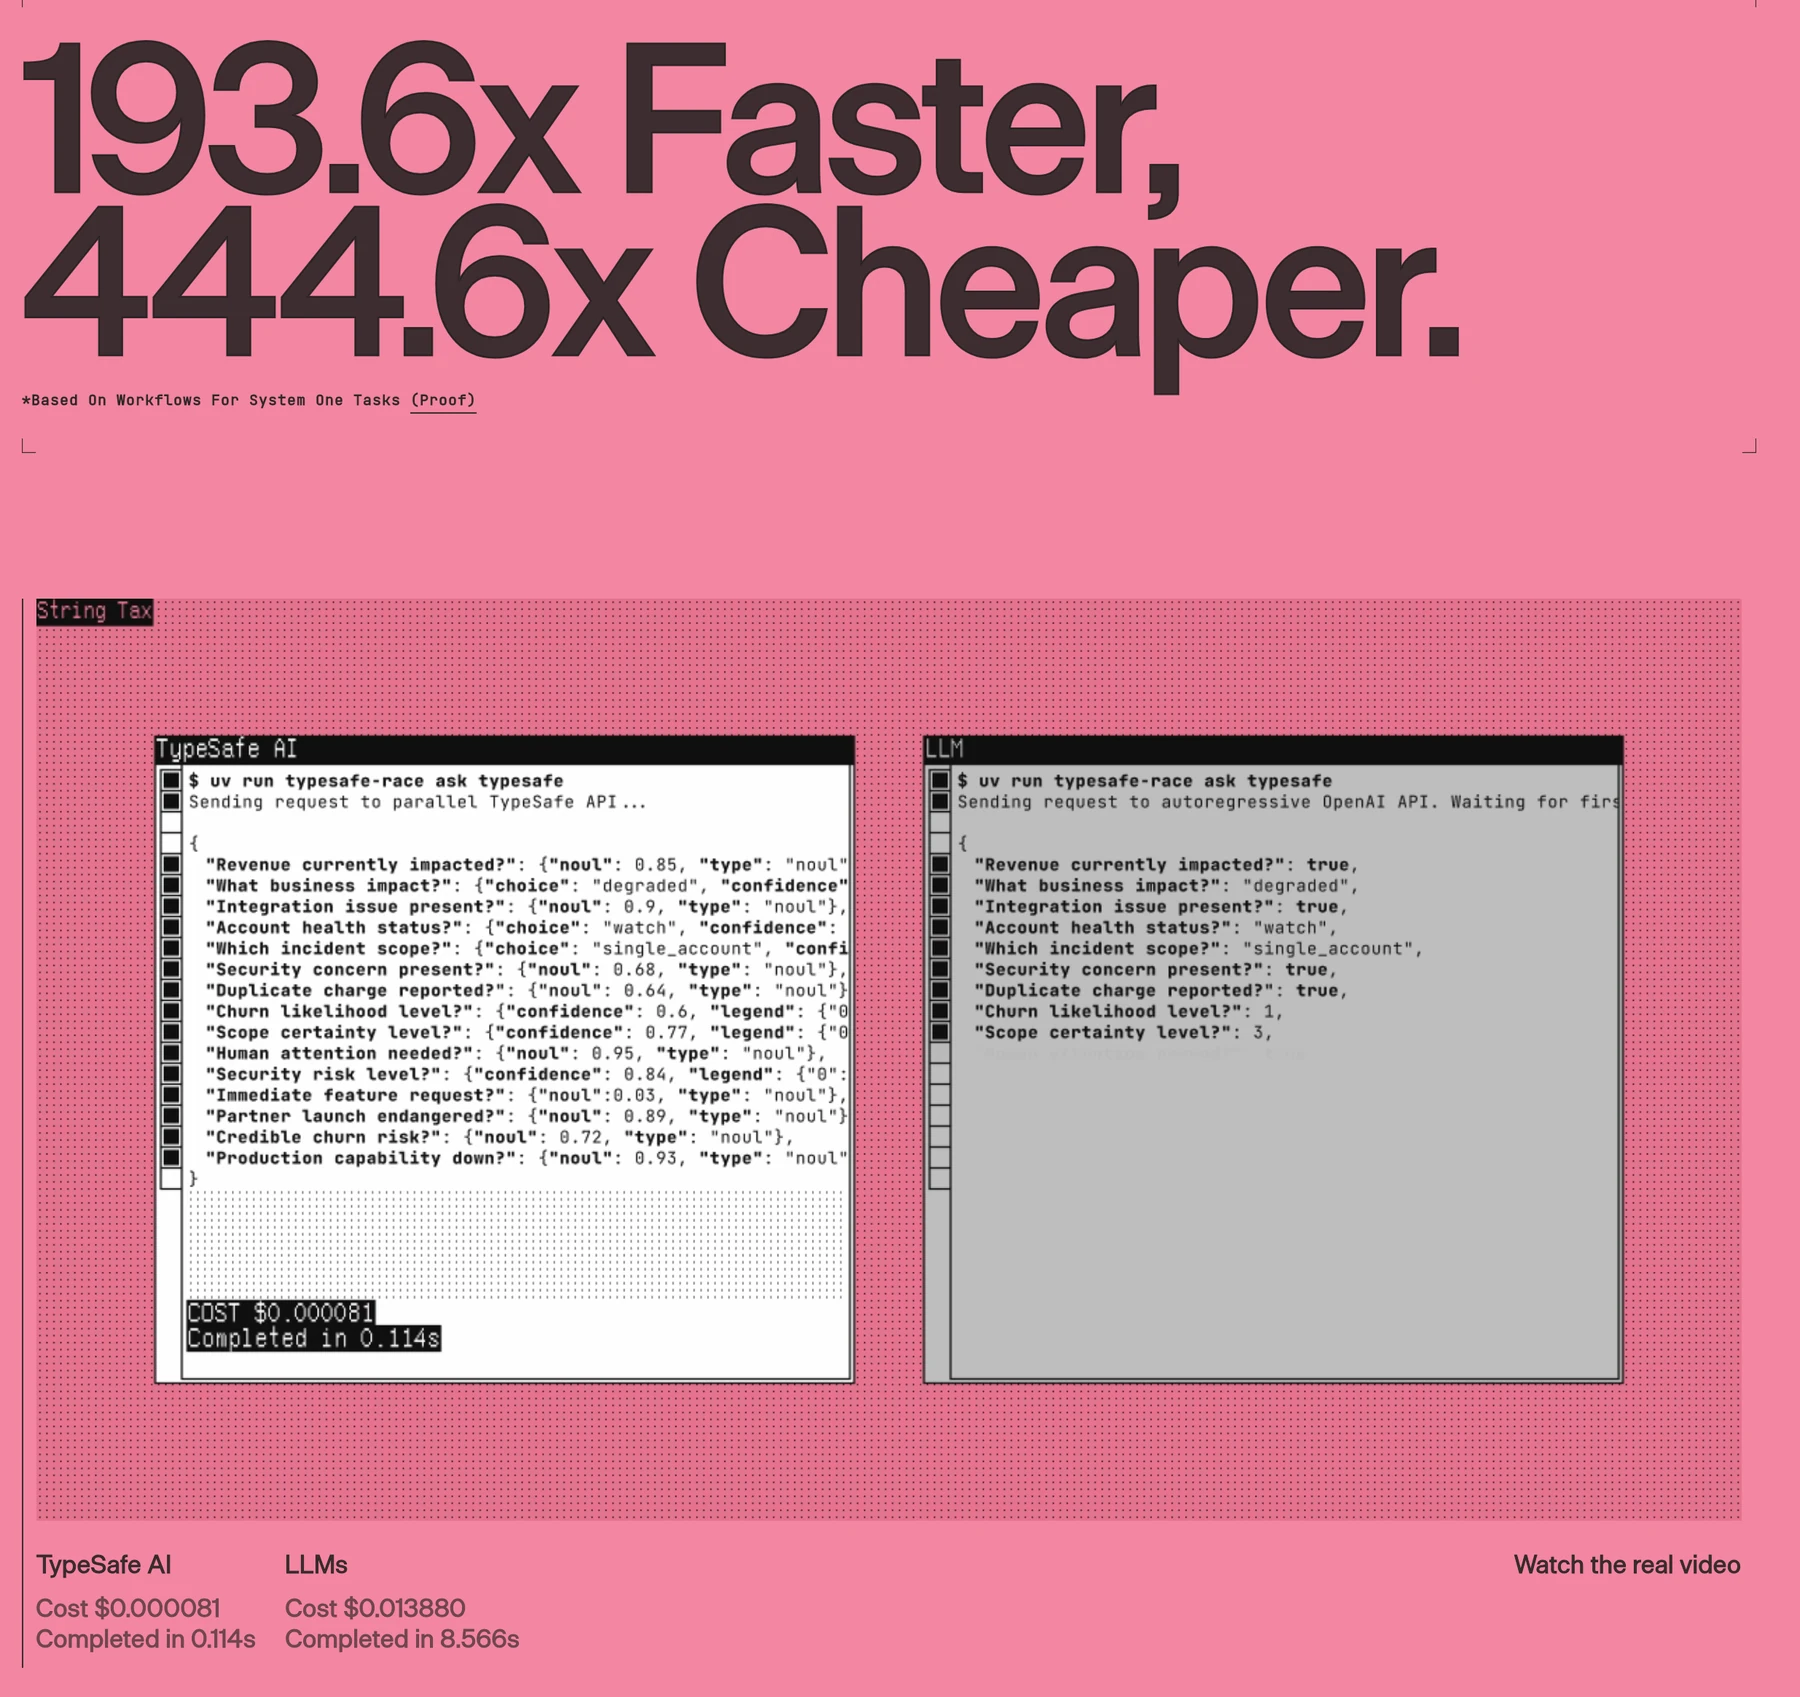
Nella demo di lancio, lo stesso set di domande di business è costato 0,000081 $ e 114 millisecondi per Jev, contro 0,013880 $ e 8,566 secondi per un LLM classico. La demo più chiacchierata è un bot che gioca a Doom: circa 10 chiamate al secondo, per un costo di gioco intorno ai 7 $ l'ora.
RLCD: la terza via dopo RLHF e RLVR
RLHF ottimizza le risposte che piacciono agli umani; RLVR premia ciò che si può verificare, ed è la ricetta dei modelli di ragionamento. RLCD, Reinforcement Learning for Calibrated Decisions, ottimizza la calibrazione: probabilità oneste, direttamente utilizzabili dal codice. È il «System 1» di Kahneman applicato ai modelli: giudizi rapidi e affidabili per le decisioni piccole, mentre il «System 2», cioè i grandi modelli, si prende ragionamento e scrittura.
Perché conta per chi automatizza
Nella maggior parte dei flussi di lavoro l'AI non serve per scrivere: serve per decidere. Questa email è urgente? Questa transazione è sospetta? Questa risposta rispetta la policy? Oggi ogni micro-decisione costa una chiamata a un modello generalista, con la sua latenza e il suo prezzo. Un modello di decisione calibrato cambia l'economia di quel livello: il codice definisce le risposte possibili, il modello assegna le probabilità, e le soglie di confidenza stabiliscono cosa fare da soli e cosa mandare a un umano. Classificazione, instradamento, guardrail, verifica degli output: tutto quello che nei sistemi agentici di oggi è «un'altra chiamata al modello».
Cosa resta da verificare
Va detto con onestà: i numeri sono auto-dichiarati, non esiste ancora un paper e non ci sono benchmark indipendenti. Jev non scrive testo, non genera codice e non legge immagini, e l'accesso è in early access su lista d'attesa. La critica più sensata letta in giro riguarda il confronto di velocità, non del tutto omogeneo: nella demo gli LLM generano l'intera risposta strutturata, nomi dei campi compresi, e un modello limitato a emettere solo la decisione sarebbe più competitivo. Anche «zero allucinazioni» va letto per quello che è: l'output non può uscire dallo schema, ma può essere sbagliato con sicurezza, cosa che la stessa azienda ha ammesso.
La direzione
Al netto del marketing, l'annuncio indica una direzione concreta: separare generazione e decisione. I modelli grandi restano il posto dove si ragiona e si scrive; le decisioni ripetute milioni di volte meritano un'infrastruttura più vicina al codice che alla conversazione. È lo stesso spostamento che si vede nei flussi agentici: meno «chiedi al modello di fare tutto», più componenti piccoli, verificabili e componibili. Se la direzione è quella giusta, il costo delle decisioni automatiche scende di ordini di grandezza, e il lavoro interessante si sposta su cosa farne.
Fonti: il post di lancio su typesafe.ai, la documentazione per sviluppatori e le eval dei workflow.